Auch KI-Agenten benötigen ein Lakehouse
KI-Agenten sind immer dann besonders wertvoll, wenn sie auf den unternehmenseigenen Daten agieren können. Dafür müssen die Informationen stimmen, mit denen sie arbeiten. Ein Beispiel aus der Fertigung zeigt, was das für Datenmodell, Ladestrecken und Agent konkret bedeutet.

In diesem Beitrag
Wer einen KI-Agenten fragt, wie oft eine Maschine im vergangenen Jahr stillstand, erwartet eine verlässliche Zahl. Ob der Agent denselben Stillstand dreimal gezählt hat, sieht man der Zahl nicht an. Die Antwort klingt in beiden Fällen gleich überzeugend.
Die Wahrscheinlichkeit für solche Fehler ist vor allem dann hoch, wenn ein Agent auf unkuratierten Rohdaten arbeitet. Derselbe Vorgang taucht in mehreren Systemen auf, Bezeichnungen unterscheiden sich, Zusammenhänge sind nicht dokumentiert. Wer Unternehmensdaten für KI-Agenten nutzbar machen will, muss deshalb vorher festlegen, was die Daten bedeuten und wie sie zusammengehören. Ein Datenmodell in einem Data Lakehouse ist der Ort, an dem diese Festlegungen landen. Es sorgt dafür, dass dieselbe Frage zu unterschiedlichen Zeitpunkten dieselbe Antwort liefert und dass sich jede Zahl bis zur Quelle zurückverfolgen lässt.
Dieser Beitrag stellt anhand eines konkreten Beispiels dar, wie eine solche Architektur umgesetzt werden kann: von den Quellsystemen über die Aufbereitung bis zur Antwort des Agenten, mit dem Datenmodell, den Regeln und den Werkzeugen, die dafür nötig sind.
Beispiel: Auswertung von Stillständen
„Welche Störungen haben im vergangenen Jahr am häufigsten zu Stillständen geführt, aufgeschlüsselt nach Fertigungslinie und Maschinentyp?“ Für eine Betriebsleitung ist das eine naheliegende Frage. Mit ihrer Antwort lässt sich entscheiden, welche Anlagen die Instandhaltung genauer untersuchen sollte.
Betrachten wir einen fiktiven Zulieferer für Präzisionsmetallbauteile mit zwei Werken. Die benötigten Informationen liegen vor: im ERP-System, in Maschinenprotokollen und in Wartungsberichten. Ein Agent erhält Zugriff auf diese Quellen und soll die Frage beantworten.
Jeder Ausfall erzeugt einen Eintrag in drei Systemen. Die Maschinensteuerung meldet einen Fehler, die Schichtleitung protokolliert einen Stillstand, die Instandhaltung schreibt einen Bericht. Alle drei Aufzeichnungen sind für sich genommen korrekt. Zählt der Agent sie als drei Ausfälle, ist seine Statistik falsch.
Vielleicht erkennt er den Zusammenhang. Vielleicht wertet er den Wartungsbericht auch als zusätzliches Ereignis. Eine ordentlich formulierte Antwort verrät nicht, welchen Weg er genommen hat. Für eine Kennzahl, auf deren Basis der Betrieb Entscheidungen trifft, ist das zu wenig.
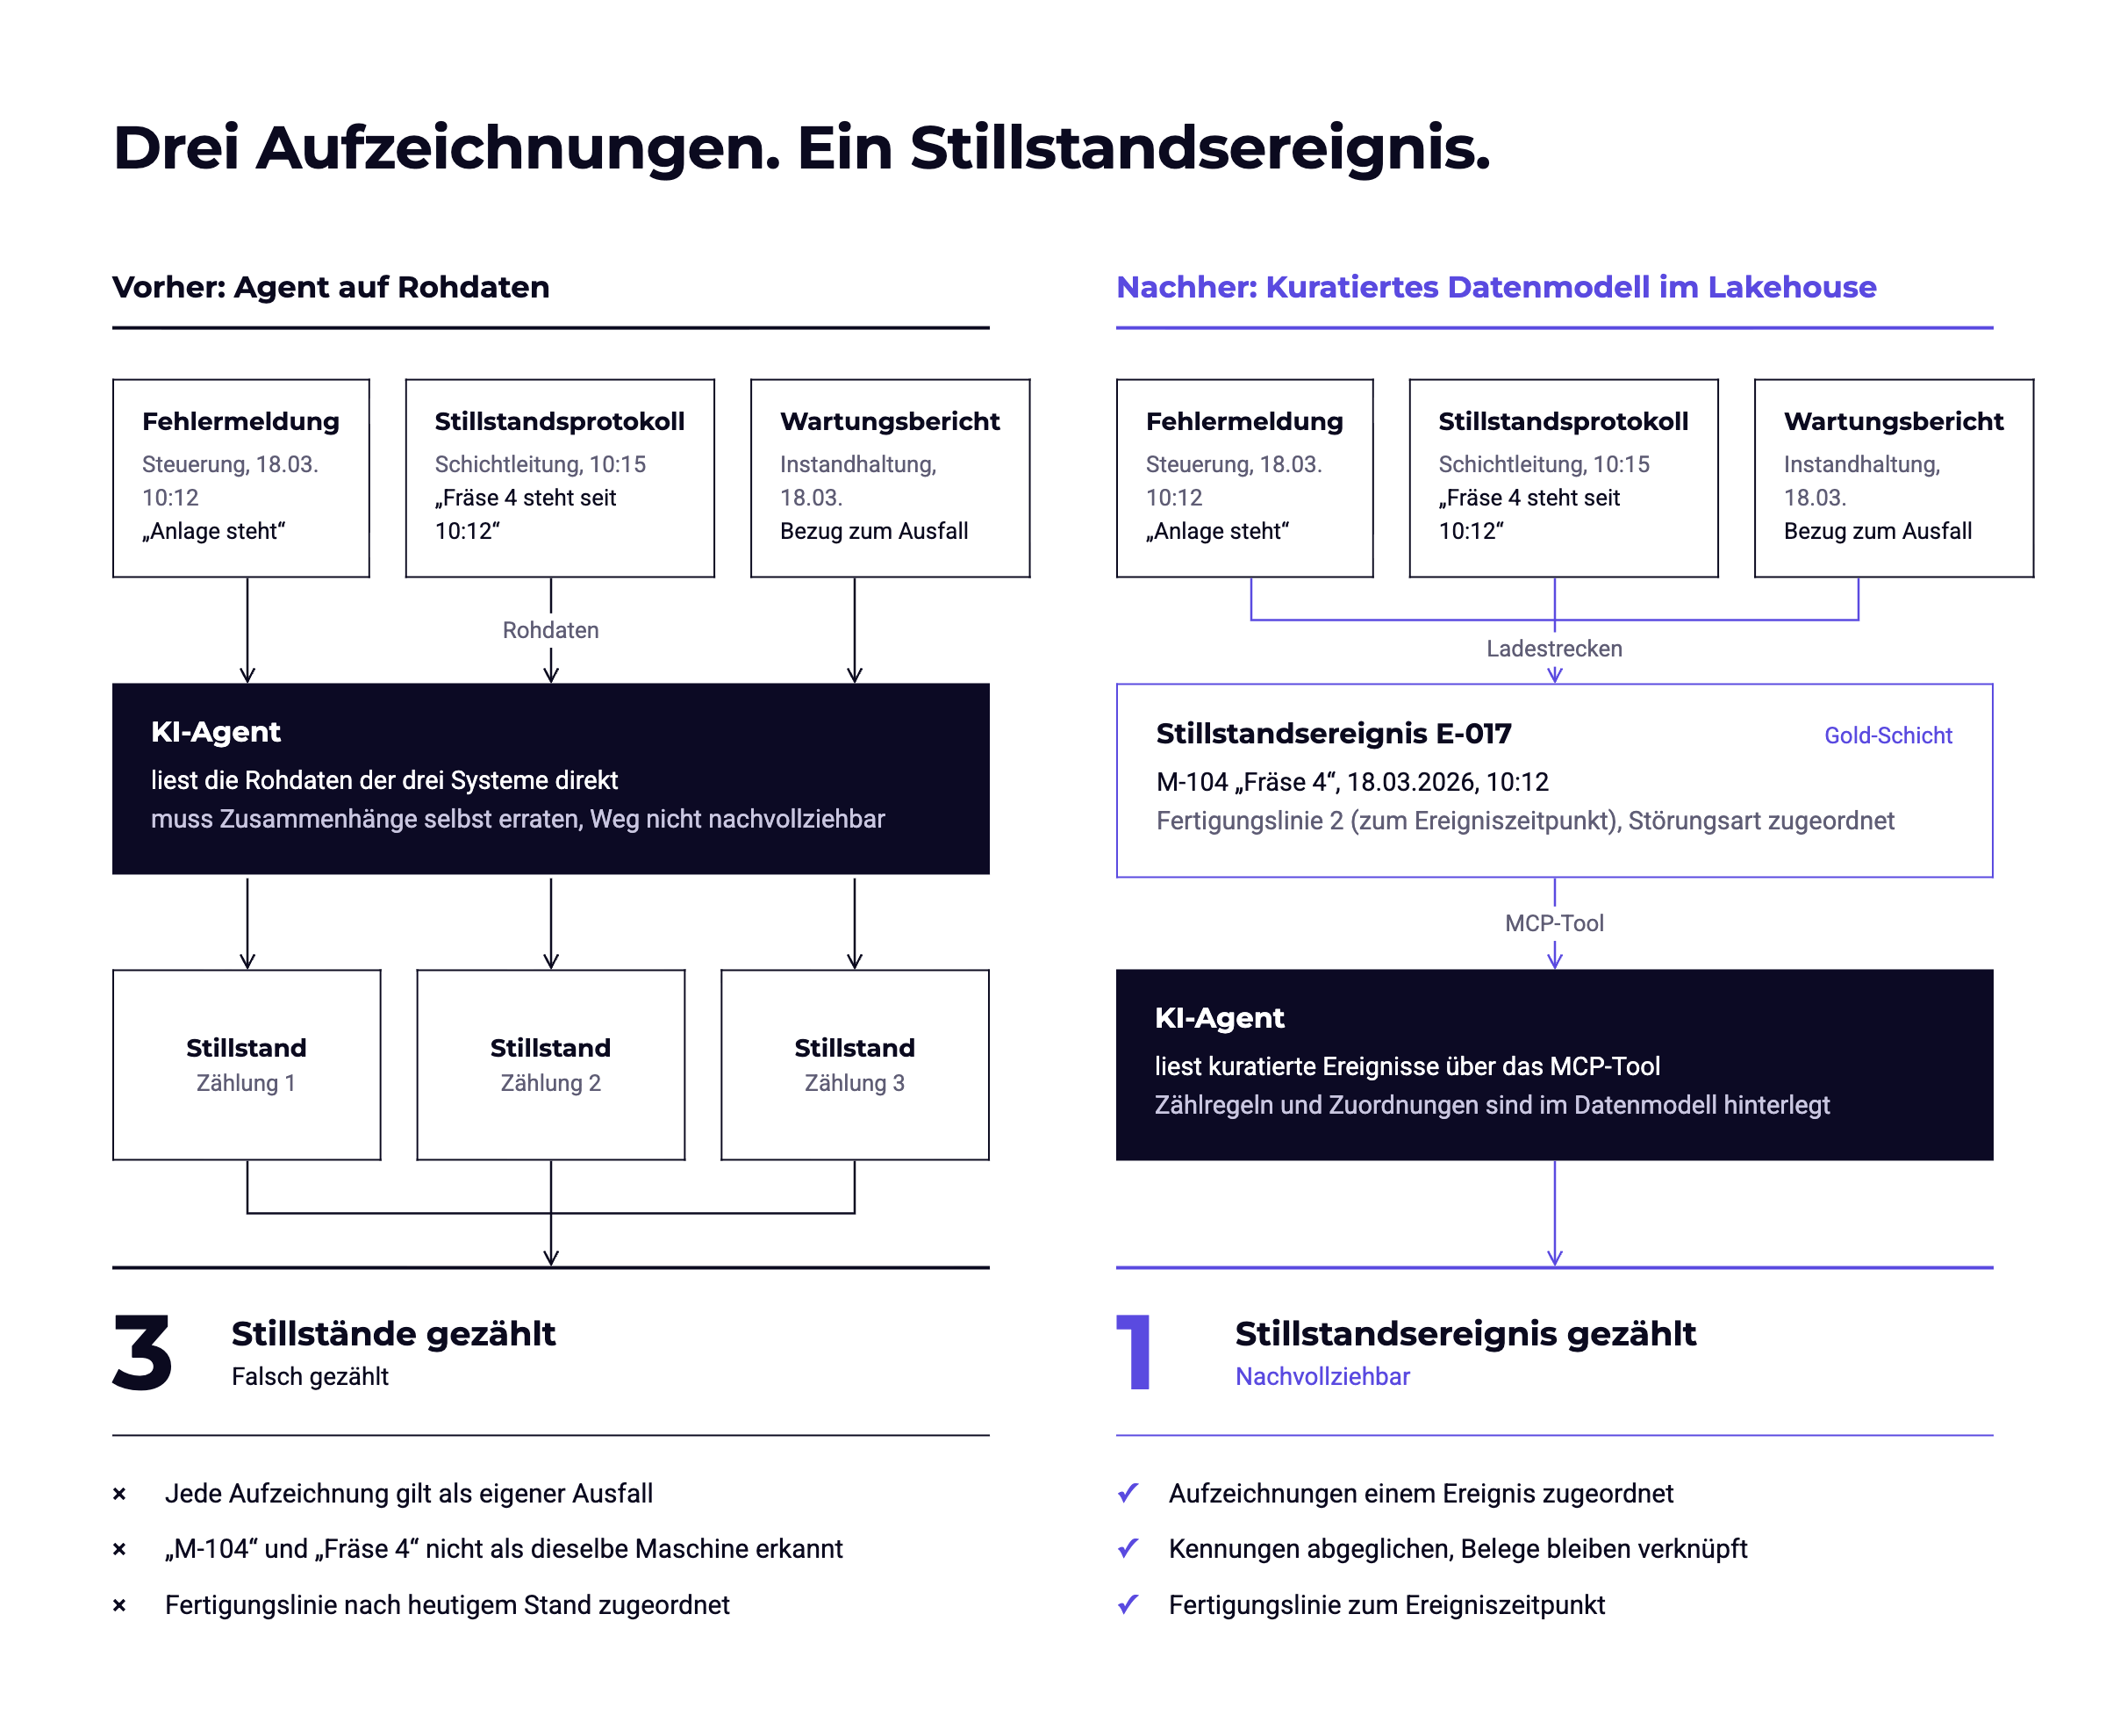
Solche Zusammenhänge sind deshalb vor der Auswertung abzubilden. Der Agent arbeitet dann mit einer nachvollziehbaren Definition von „Stillstand“, statt sie bei jeder Anfrage neu zu erraten.
Wie die Datenaufbereitung im Lakehouse funktioniert
In einem Data Lakehouse lassen sich Daten aus verschiedenen Quellen zusammenführen und für die Auswertung aufbereiten. Die ursprünglichen Einträge bleiben erhalten. Daneben entstehen bereinigte und fachlich modellierte Bestände, auf die Anwendungen zugreifen.
Für diesen Weg hat sich die Aufteilung in Bronze, Silver und Gold etabliert. Entscheidend ist, welche Logiken und Regeln zur Verarbeitung der Daten zwischen ihnen definiert sind. Diese Regeln erarbeiten Fachbereich und Datenteam gemeinsam. Umgesetzt werden sie in Ladestrecken, also Pipelines, die Daten von einer Schicht in die nächste überführen. Die Datenbestände aller drei Schichten lassen sich im AltaSigma Data Management verwalten.
Bronze: Daten übernehmen und ihre Herkunft behalten
Beim Zulieferer werden die Anlagenstammdaten regelmäßig aus dem ERP abgerufen, Maschinenmeldungen treffen laufend ein, Wartungsberichte kommen als Dokumente. Für die Anbindung der üblichen Quellen, ob Batch, Dateitransfer oder Streaming, stehen im Data Management entsprechende Adapter bereit. Eine Übersicht gibt die Plattformseite zu Data Management und Data Engineering.
In der Bronze-Schicht bleiben die Daten weitgehend in ihrer ursprünglichen Form. Zu jedem Eintrag hält die Ladestrecke fest, aus welchem System er stammt und wann er eingegangen ist. Dadurch lässt sich später nachvollziehen, auf welchen Meldungen eine Auswertung beruht.
Die Herkunftsinformation ist auch für Korrekturen relevant. Hat eine Verarbeitungsregel Meldungen falsch behandelt, lässt sich die korrigierte Regel erneut auf die ursprünglichen Daten anwenden. Ein neuer Export aus dem Quellsystem ist dafür nicht nötig.
Silver: Dieselbe Maschine in verschiedenen Quellen erkennen
In der Silver-Schicht geht es zunächst darum, dieselbe Maschine über mehrere Quellen hinweg zu erkennen. Im ERP heißt eine Anlage „M-104“, im Wartungsbericht „Fräse 4“, in der Steuerung vielleicht nur „Station 4/2“. Das Ergebnis dieser Arbeit ist eine Zuordnungstabelle:
| maschine_id | quelle | bezeichnung_in_quelle | gueltig_von | gueltig_bis |
|---|---|---|---|---|
| M-104 | ERP | M-104 | 2019-01-01 | – |
| M-104 | Instandhaltung | Fräse 4 | 2019-01-01 | – |
| M-104 | Steuerung | Station 4/2 | 2024-06-01 | – |
Bei einer unklaren Zuordnung ist eine Rückfrage im Betrieb verlässlicher als eine Vermutung anhand ähnlich klingender Namen. Fälle ohne eindeutige Zuordnung bleiben als ungeklärt markiert und gehen nicht unbemerkt in die Kennzahl ein.
Beim Abgleich vereinheitlicht die Ladestrecke auch Zeitangaben und erkennt mehrfach gelieferte Datensätze. Dabei ist eine Unterscheidung wichtig: Eine versehentlich doppelt eingelesene Fehlermeldung ist etwas anderes als ein Wartungsbericht über denselben Ausfall. Der Bericht enthält zusätzliche Informationen und bleibt als eigener Beleg erhalten.
Auch Angaben aus Texten lassen sich einbeziehen. Ein Sprachmodell kann aus einem Wartungsbericht die Maschinenkennung oder die durchgeführte Maßnahme extrahieren. Diese Angaben werden vor der Übernahme geprüft wie jede andere Quelle auch.
Diese Ladestrecken lassen sich in AltaSigma mit Python oder PySpark entwickeln oder grafisch im Flow Designer aufbauen.
Gold: Aus Meldungen auswertbare Stillstandsereignisse machen
Die Gold-Schicht beantwortet die Betriebsfrage. Jedes Stillstandsereignis beschreibt dort die betroffene Maschine, den Zeitraum, die Störungsart und die Fertigungslinie zum Zeitpunkt des Ereignisses:
| Spalte | Inhalt |
|---|---|
| ereignis_id | eindeutige Kennung, z. B. E-017 |
| maschine_id | aus der Zuordnungstabelle |
| linie_id | Fertigungslinie zum Ereigniszeitpunkt |
| beginn, ende | aus der frühesten bzw. spätesten zugeordneten Meldung |
| stoerungsart | aus Steuerungscode oder Wartungsbericht |
| quellen | Verweise auf Fehlermeldung, Protokoll und Bericht in Bronze |
Fachliche Regeln legen fest, welche Meldungen zu einem Ereignis gehören. Beim Zulieferer lautet die Regel etwa: Eine Fehlermeldung der Steuerung eröffnet ein Ereignis. Ein Stillstandsprotokoll derselben Maschine, das innerhalb von 30 Minuten danach beginnt, gehört dazu. Ein Wartungsbericht gehört dazu, wenn er dieselbe Maschine nennt und sein Datum in das Zeitfenster des Ereignisses fällt. Zeitliche Nähe allein reicht nicht, denn zwei kurz aufeinanderfolgende Meldungen können unterschiedliche Störungen beschreiben. Deshalb zählt auch der dokumentierte Verlauf.
Zur Auswertung gehört die richtige Fertigungslinie. Hat eine Maschine während des Jahres die Linie gewechselt, muss ein früherer Ausfall ihrer damaligen Linie zugeordnet werden. Das Modell führt die Zuordnung von Maschine zu Linie deshalb mit Gültigkeitszeitraum, so wie die Zuordnungstabelle oben. Eine Zuordnung nach dem heutigen Standort würde das Ergebnis verfälschen.
Was als Stillstand zählt, legt der Fachbereich fest. Gehören geplante Wartungen dazu? Ab welcher Dauer zählt eine Unterbrechung? Geht es um die häufigsten Ausfälle oder um Störungen mit der längsten Gesamtdauer? Eine häufige Störung kann weniger Betriebszeit kosten als ein einziger langer Ausfall. Die ursprüngliche Frage zielt auf die Häufigkeit. Eine Auswertung nach Dauer beantwortet eine andere Frage. Diese Festlegungen werden als Kennzahlendefinition zur Gold-Tabelle hinterlegt, damit jeder, der die Tabelle nutzt, dieselbe Definition verwendet: Agent, BI-Bericht und Datenteam.
Am Ende steht ein Datenmodell, in dem der dreifach dokumentierte Stillstand als ein Ereignis auswertbar ist. Die zugrunde liegenden Meldungen bleiben verknüpft. Fachleute können prüfen, warum ein Ereignis gezählt und einer bestimmten Maschine oder Linie zugerechnet wird.
Ladestrecken laufend betreiben
Die Ladestrecken verarbeiten auch neu eintreffende Daten nach denselben Regeln. Die AltaSigma Orchestration führt die Jobs zum Beispiel nach einem festen Zeitplan aus, etwa für den regelmäßigen Abruf der Stammdaten. Streaming-Quellen liefern laufend. Wie aktuell die Auswertung sein muss, bestimmt den Takt: Für einen Jahresrückblick gelten andere Anforderungen als für die Frage, welche Maschinen gerade stillstehen. Die Job-Orchestrierung ist Teil der AltaSigma-Plattform.
Der Agent hilft beim Bau der Ladestrecken
KI-Agenten müssen nicht erst ins Spiel kommen, wenn die Daten fertig aufbereitet sind. Aus dem Schema der Quelldaten, dem Zielmodell und den vereinbarten fachlichen Regeln kann ein Agent den PySpark-Code für eine Ladestrecke entwerfen und passende Datentests vorschlagen, etwa einen Test, der sicherstellt, dass kein Ereignis ohne gültige Linienzuordnung entsteht.
Der Unterschied zum Agenten auf Rohdaten liegt darin, wann die Logik entsteht und wer sie prüft. Der generierte Code wird vom Datenteam gelesen, getestet und freigegeben. Danach läuft er deterministisch und für alle Anfragen gleich. Der Agent, der später Betriebsfragen beantwortet, greift auf das Ergebnis zu, statt die Logik bei jeder Anfrage selbst erkennen und ausführen zu müssen.
Wie der Agent die Betriebsfrage beantwortet
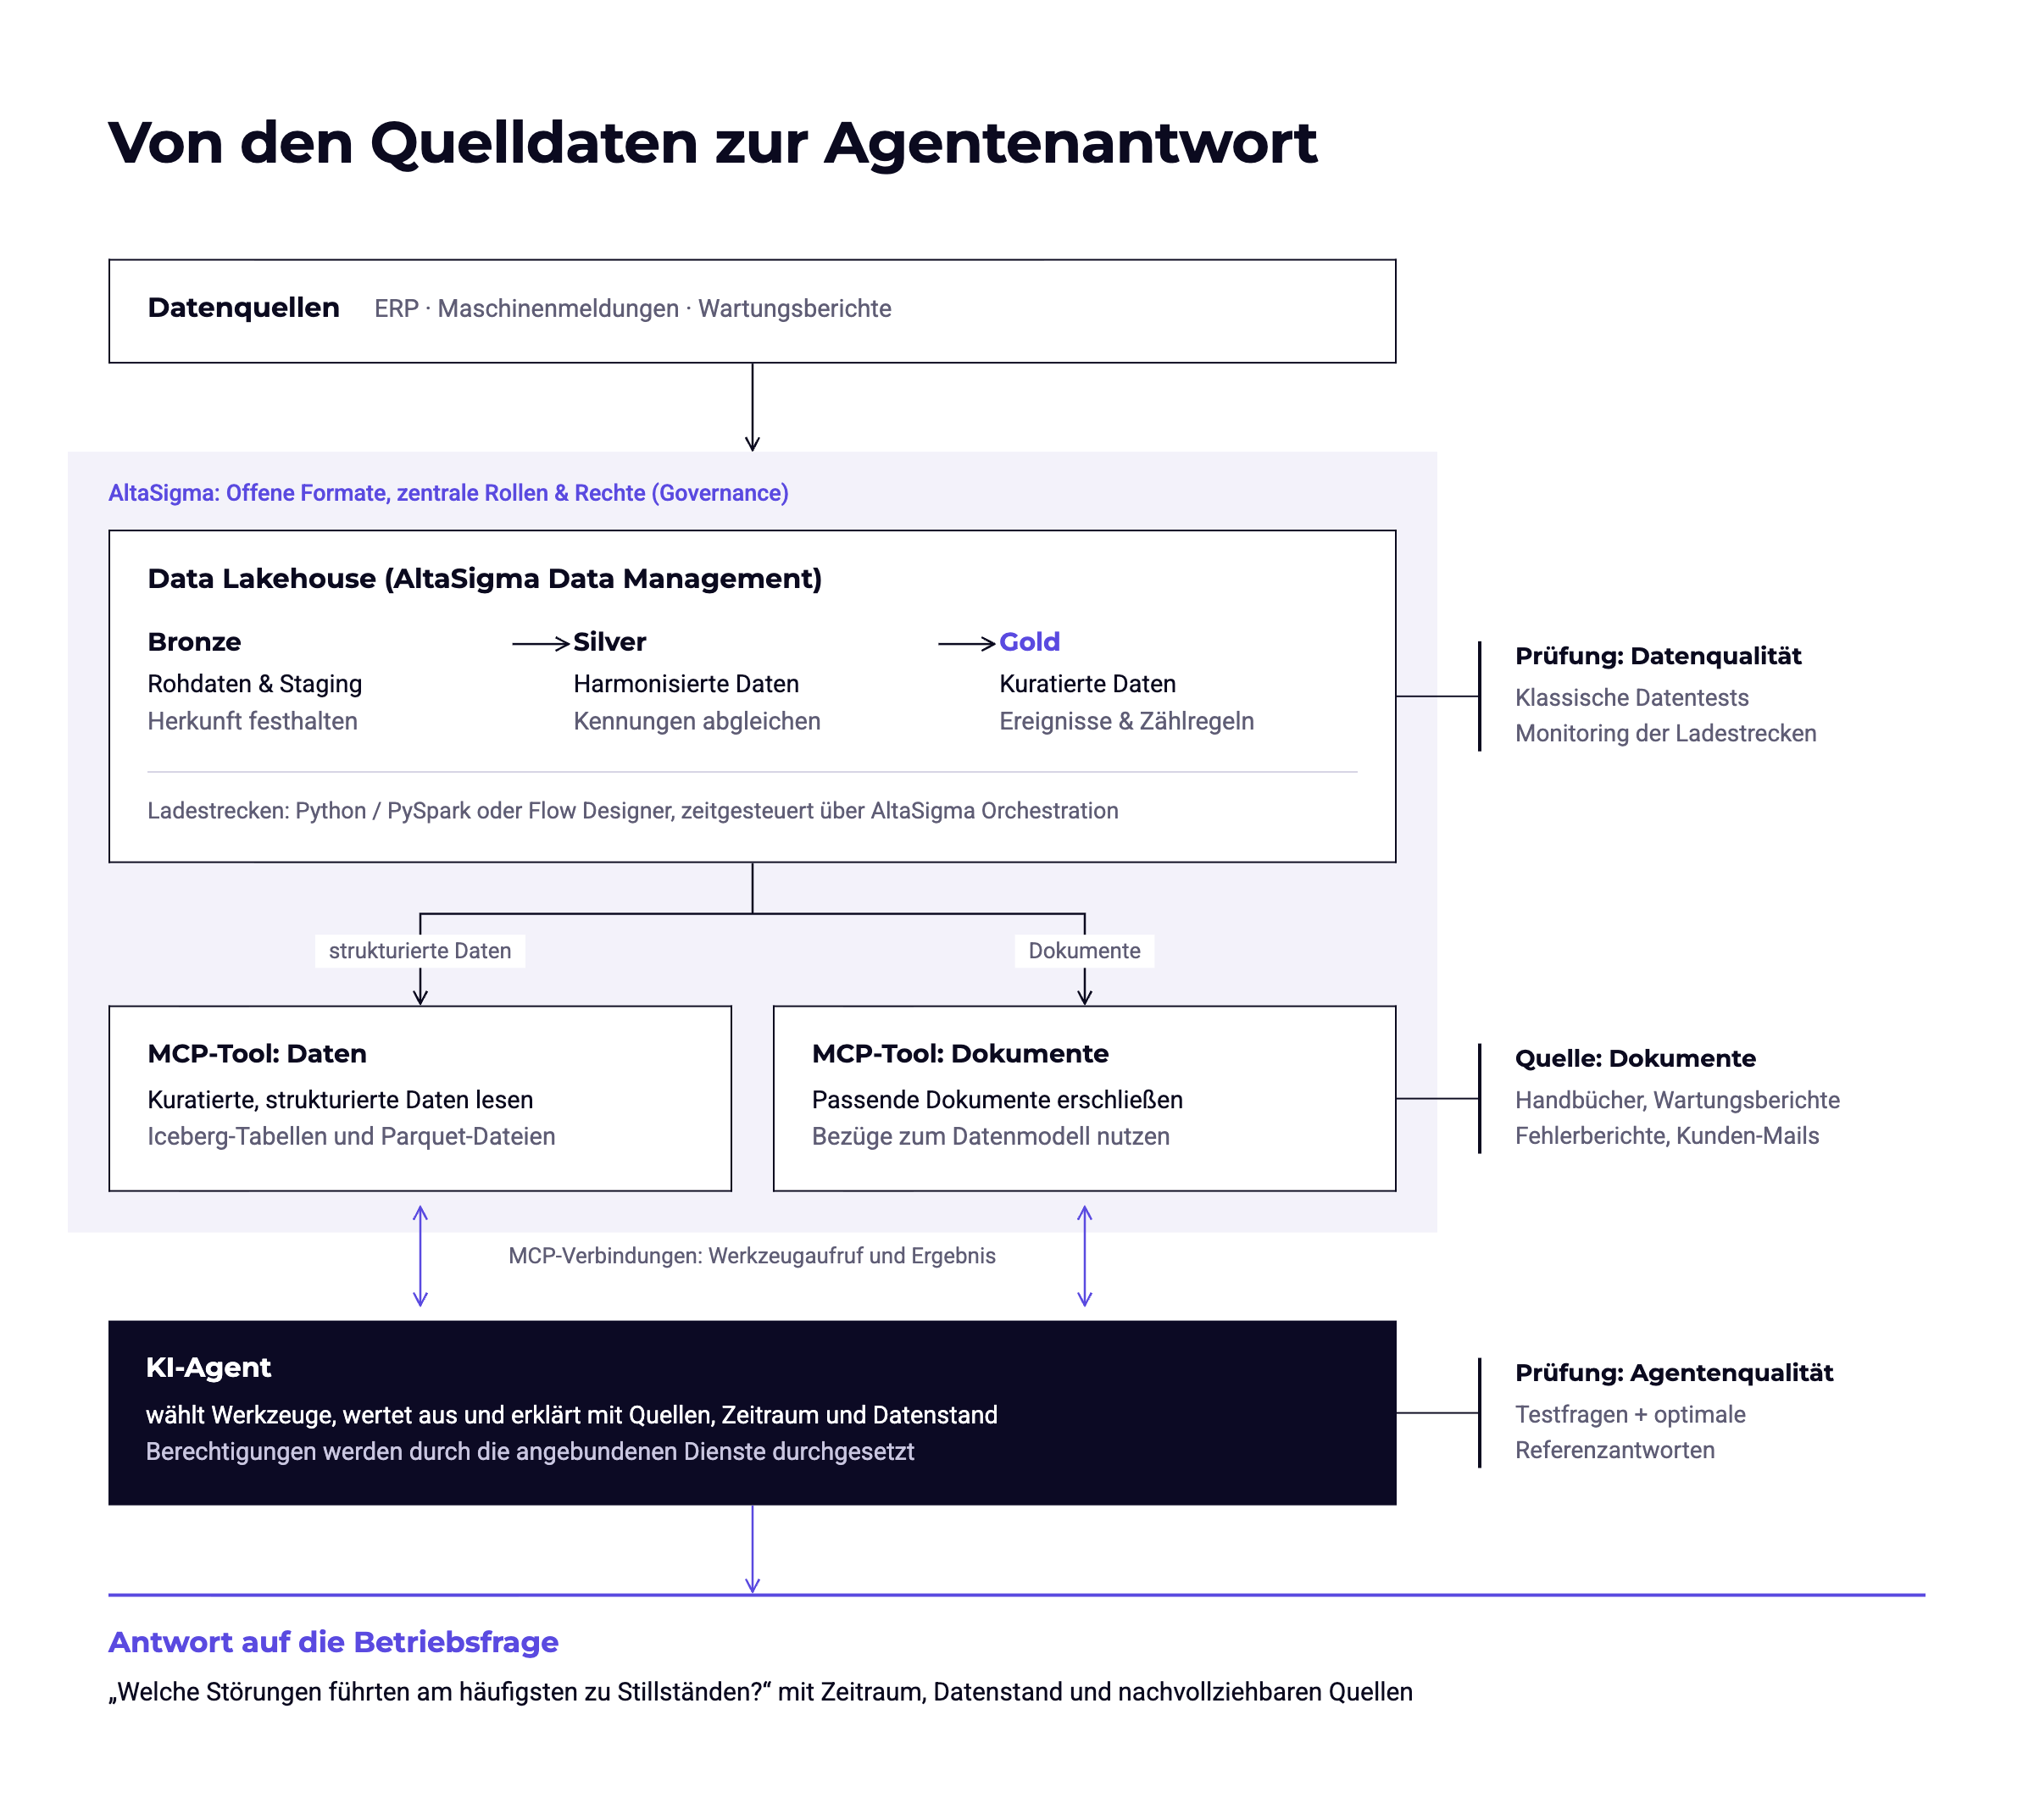
Auf die aufbereiteten Bestände greift der Agent über MCP-Tools zu. Das Model Context Protocol, kurz MCP, beschreibt die Schnittstelle, über die ein Agent Werkzeuge aufruft. Als Ausgangspunkt dient ein generisches Werkzeug: Es nimmt eine SQL-Abfrage entgegen und führt sie auf den Gold-Tabellen aus, die als Iceberg-Tabellen beziehungsweise Parquet-Dateien vorliegen. Damit der Agent die richtige Abfrage formulieren kann, liest er vorab die Beschreibung der Tabelle und die dort hinterlegte Kennzahlendefinition. Für die Stillstandsfrage ergibt sich daraus die folgende Abfrage:
-- Kennzahlendefinition aus den Metadaten der Tabelle:
-- ungeplante Unterbrechungen ab 5 Minuten, geplante Wartungen ausgenommen

SELECT e.linie_id, m.maschinentyp, e.stoerungsart, COUNT(*) AS anzahl
FROM gold.stillstandsereignis e
JOIN gold.maschine m ON m.maschine_id = e.maschine_id
WHERE e.beginn >= DATE '2025-01-01' AND e.beginn < DATE '2026-01-01'
  AND e.stoerungsart <> 'Geplante Wartung'
  AND e.ende - e.beginn >= INTERVAL '5' MINUTE
GROUP BY e.linie_id, m.maschinentyp, e.stoerungsart
ORDER BY anzahl DESC;
Die Zusammenführung der Meldungen zu Ereignissen hat die Ladestrecke bereits erledigt. Der Agent wertet aus, was im Datenmodell steht. Die Zählregeln liest er aus der Kennzahlendefinition an der Tabelle, nicht aus dem Prompt. Er muss aber weiterhin Zeitraum, Filter und Gruppierung richtig in die Abfrage übersetzen und das Ergebnis einordnen. Darauf kommen wir bei der Prüfung zurück.
Für Fragen, die häufig gestellt werden oder bei denen die Abfrage fehleranfällig ist, kann zusätzlich ein spezifisches MCP-Tool sinnvoll sein, etwa stillstandsereignisse_auswerten mit Zeitraum und Gruppierung als Parametern. Die Kennzahlendefinition steckt dann fest im Werkzeug, und der Agent muss die Abfrage nicht mehr selbst formulieren. Ob ein solches Werkzeug erforderlich ist, lässt sich an den Evaluationsergebnissen im Betrieb ablesen.
Soll die Antwort erläutern, was hinter einem dokumentierten Fehler steckt, kommen weitere MCP-Tools zum Einsatz. Sie erschließen Dokumente und deren Bezüge zum Datenmodell, etwa den Wartungsbericht zur betroffenen Maschine oder die passende Handbuchversion. Dieses Abrufen von Informationen als Grundlage einer generierten Antwort wird als Retrieval-Augmented Generation (RAG) bezeichnet. Die strukturierte Auswertung liefert die Häufigkeit. Die Dokumente ergänzen Hinweise zu Fehlerbildern und beschriebenen Maßnahmen. Eine passende Handbuchstelle beweist allerdings noch nicht die Ursache eines konkreten Ausfalls.
Eine für die Betriebsleitung verwertbare Antwort enthält Zeitraum, Datenstand und Quellen – im Beispiel:
Wie sich Wissen aus Tickets und Dokumenten erschließen lässt, zeigt der Beitrag über KI-Agenten für die Bearbeitung von Kundenanfragen.
Wie lässt sich prüfen, ob die Antwort stimmt?
Die Qualität der Daten und die Antworten des Agenten lassen sich getrennt prüfen.
Auf Datenebene kommen Datentests und das Monitoring der Ladestrecken zum Einsatz. Tests erkennen fehlende Maschinenkennungen oder widersprüchliche Zeitangaben. An bekannten Fällen lässt sich prüfen, ob die fachlichen Regeln greifen: Zählt der dreifach dokumentierte Ausfall vom 18.03. genau einmal? Bleibt die historische Linienzuordnung erhalten? Solche Tests helfen auch dann, wenn sich später eine Quelle oder eine Berechnung ändert. Das Monitoring zeigt, ob eine erwartete Datenlieferung ausgeblieben ist oder eine Ladestrecke nicht wie vorgesehen gelaufen ist.
Auf Agentenebene dienen Evaluations-Suites mit Testfragen und Referenzantworten der Qualitätsprüfung. Ein Testfall umfasst die Frage, die erwartete Antwort und die Anforderungen an deren Inhalt:
Nach Änderungen an Daten, Werkzeugen oder Agentenkonfiguration lassen sich dieselben Fragen erneut stellen und die Ergebnisse vergleichen.
Fälle mit fehlenden Informationen sind ein eigener Prüfschwerpunkt. Fehlen die Meldungen einer Schicht, darf daraus kein störungsfreier Betrieb werden. Der Agent sollte die Einschränkung benennen. Korrekte Daten allein garantieren also noch keine korrekte Antwort. Deshalb braucht es beide Prüfebenen.
Zum Betrieb gehören außerdem Zuständigkeiten und Zugriffsrechte. Es muss feststehen, wer Maschinenzuordnungen pflegt, wer Kennzahlendefinitionen ändern darf und wer welche Daten sehen kann. Die angebundenen Dienste setzen diese Rechte auch beim Abruf durch den Agenten und bei der Dokumentensuche durch.
Mit einer Fertigungslinie beginnen
Für ein erstes Projekt muss nicht das gesamte Unternehmen modelliert werden. Beim Zulieferer genügt eine Fertigungslinie und die Frage, welche Störungen dort am häufigsten zu Stillständen führen. Vorhandene Stammdaten, Datenplattformen und bereits abgestimmte BI-Kennzahlen sind der Ausgangspunkt.
Fachbereich und Datenteam legen gemeinsam fest, wie eine richtige Antwort aussieht. Das Datenteam prüft die Quellen und setzt Zuordnungen und Berechnungen um. Am Ende muss sich zeigen lassen, dass der Agent den mehrfach dokumentierten Ausfall einmal zählt, der richtigen Linie zuordnet und seine Angaben belegt. Daran lässt sich der Fortschritt besser beurteilen als an einer einzelnen überzeugend formulierten Demo-Antwort.
Wie aufwendig der Einstieg wird, hängt vor allem von den vorhandenen Daten und dem dokumentierten Betriebswissen ab. Fehlende Zuordnungen müssen geklärt werden, bewährte Definitionen können übernommen werden. Weitere Linien und Fragen kommen hinzu, wenn der erste Umfang funktioniert.
Die aufbereiteten Daten stehen anschließend auch anderen Anwendungen zur Verfügung. BI-Berichte greifen auf dieselben Kennzahlendefinitionen zurück. Maschinelles Lernen benötigt je nach Aufgabe detailliertere Messwerte und Ereignisse, profitiert aber ebenfalls von geklärten Zuordnungen und geprüften Daten.
Kundenservice·8 Min. Lesezeit
KI-Agenten für die Bearbeitung von Kundenanfragen
Artikel lesen
LLM·14 Min. Lesezeit
Schneller, smarter, besser: LLMs als Gamechanger für Data Science
Artikel lesen
Uplift Modeling·6 Min. Lesezeit